Showing posts with label Akustik. Show all posts

Thursday, January 27, 2022

Ekstraksi Fitur Akustik dengan Torchaudio

Kode di bawah ini mengekstrak tiga fitur akustik -- spectrogram, melspectrogram, dan mfcc -- dari sebuah file audio "filename" (wav, mp3, ogg, flacc, dll). Ketiga fitur akustik tersebut merupakan fitur-fitur akustik terpenting dalam pemrosesan sinyal wicara. Keterangan singkat ada di dalam badan kode. Hasil plot ada di bawah kode.

###
#import torch
import torchaudio
from matplotlib import pyplot as plt
import librosa

# show torchaudio version
# torch.__version__
print(torchaudio.__version__)


def plot_spectrogram(spec, title=None, ylabel="freq_bin", aspect="auto",
                     xmax=None):
    fig, axs = plt.subplots(1, 1)
    axs.set_title(title or "Spectrogram (db)")
    axs.set_ylabel(ylabel)
    axs.set_xlabel("frame")
    im = axs.imshow(librosa.power_to_db(spec), origin="lower", aspect=aspect)
    if xmax:
        axs.set_xlim((0, xmax))
    fig.colorbar(im, ax=axs)
    plt.show(block=False)


filename = "/home/bagus/train_001.wav"  # change with your file
waveform, sample_rate = torchaudio.load(filename)

# Konfigurasi untuk spectrogam, melspectrogram, dan MFCC
n_fft = 1024
win_length = None  # jika None maka sama dengan n_fft
hop_length = 512   # y-axis in spec plot
n_mels = 64  # y-axis in melspec plot
fmin = 50
fmax = 8000
n_mfcc = 40  # must be smaller than n_mels, will be y-axis in plot

# definisi kelas untuk ekstraksi spektrogram
spectrogram = torchaudio.transforms.Spectrogram(
    n_fft=n_fft,
    win_length=win_length,
    hop_length=hop_length,
    center=True,
    pad_mode="reflect",
    power=2.0,
)

# Show plot of spectrogram
spec = spectrogram(waveform)
print(spec.shape)  # torch.Size([1, 513, 426])
plot_spectrogram(spec[0], title=f"Spectrogram - {str(filename)}")


## kelas untuk ekstraksi melspectrogram
melspectogtram = torchaudio.transforms.MelSpectrogram(
    sample_rate=sample_rate,
    n_fft=n_fft,
    win_length=win_length,
    hop_length=hop_length,
    n_mels=n_mels,
    f_min=fmin,
    f_max=fmax,
)

# Calculate melspec
melspec = melspectogtram(waveform)
melspec.shape # torch.Size([1, 513, 426])
plot_spectrogram(melspec[0], title=f"Melspectrogam - {str(filename)}")

## kelas untuk ekstraksi MFCC
mfcc_transform = torchaudio.transforms.MFCC(
    sample_rate=sample_rate,
    n_mfcc=n_mfcc,
    melkwargs={
      'n_fft': n_fft,
      'n_mels': n_mels,
      'hop_length': hop_length,
      'mel_scale': 'htk',
    }
)

# plot mfcc
mfcc = mfcc_transform(waveform)
print(mfcc.shape) # torch.Size([1, 40, 426])
plot_spectrogram(mfcc[0], title=f"MFCC - {str(filename)}")
###

Plot 


Friday, July 03, 2020

Outline: Persepsi pendengaran manusia dan pemodelannya

Berikut adalah outline catatan kuliah "Human Perceptual Systems and its Models" yang diajarkan oleh Prof. Unoki di JAIST pada tahun 2018. Agar tidak menguap begitu saja, catatan-catatan tersebut saya cantumkan di sini. Kuliah ini sangat berguna bagi mereka yang ingin mempelajari bagaimana sistem pendengaran manusia bekerja (auditory system) serta model komputasinya.
  1. Pengantar persepsi manusia dan pemodelannya
  2. Pengolahan sinyal auditori
  3. Representasi suara dan pemrosesannya
  4. Analisa sinyal suara dan teknik sintesis
  5. Fisiologi dari peripheral auditori dan pemodelannya
  6. Ketidaklinearan sistem pendengaran
  7. Atensi, hubungannya dengan cocktail party problem dan deeplearning
  8. Ketidaksinkronan mata dan telinga: Efek McGurk
Opsional:  
 Satu hal yang paling menarik dari kuliah tersebut adalah bagaimana membuat model yang meniru (imitate) bagaimana sistem pendengaran manusia bekerja. Meski tidak semua dapat dimodelkan dengan eksak, dan tidak semua model yang meniru cara kerja manusia lebih baik dari model lain (misal, deep learning), model dengan hasil terbaiklah yang dipakai. Dan biasanya model terbaik tersebut merupakan kompromi antara peniruan cara kerja manusia dan, misalnya, deep learning.

Catatan kuliah ini juga disimpan di Github pada alamat berikut: https://github.com/bagustris/perseptual.

Saturday, May 09, 2020

Ketidaksinkronan telinga dan mata: Efek McGurk

Efek McGurk adalah salah satu contoh nyata pemrosesan multimodal manusia (human multimodal perception). Sederhananya, jika apa yang diperdengarkan berbeda dengan apa yang diperlihatkan, maka otak kita akan menerimanya dengan berbeda juga.

Yang diperdengarkan (audio): BA-BA-BA
Yang diperlihatkan (visual): GA-GA-GA
Yang terdengar: DA-DA-DA

Ini adalah sebuah ilusi. Sistem multimodal persepsi manusia tidak bekerja sendiri-sendiri (misal penglihatan sendiri, pendengaran sendiri), namun bekerja bersama-sama untuk menghasilkan persepsi (dalam hal ini persepsi pendengaran). Ketika sensor bekerja secara simultan (mata dan telinga) maka informasi dari keduanya akan diproses oleh otak dan hasilnya, terjadilah ilusi, apa yang terdengar (DA) bukan sebenarnya (BA). Video di bawah ini menjelaskan dengan singkat dan padat tentang efek McGurk.


Efek McGurk pada Audio-Textual

Adakah efek McGurk pada Audio-textual? Saya meyakininya ada, namun belum ada bukti empiris hal itu terjadi. Sederhana saja, jika pada audio-visual fenomena tersebut ada, kenapa tidak pada audio-textual? Misal Si A mengatakan "Dia marah", namun si B mendengar "Dia ramah". Alhasil, si B kemudian menimpali "Ah enggak, dia enggak ramah sama sekali." Pernah kan kita dalam situasi seperti ini? Fenomena ini asyik kalau dibuat eksperimennya. Semoga kelak saya (atau orang lain) bisa melakukannya.

Penutup

Efek McGurk mengajarkan kepada kita: Apa yang kita dengar dan kita lihat belum tentu benar!.

Wednesday, June 19, 2019

Implementasi Pengenalan Emosi dari Sinyal Wicara Berbasis Deep Learning dengan Keras

Tulisan ini agak panjang, membahas implementasi pengenalan emosi dari sinyal wicara dengan teknik deep learning. Perkakas yang akan kita pakai adalah Keras. Kode python yang dipakai sebenarnya bukan dari saya, namun saya modifikasi dari [1] dan [2]. Baiklah, mari kita mulai.

Ide

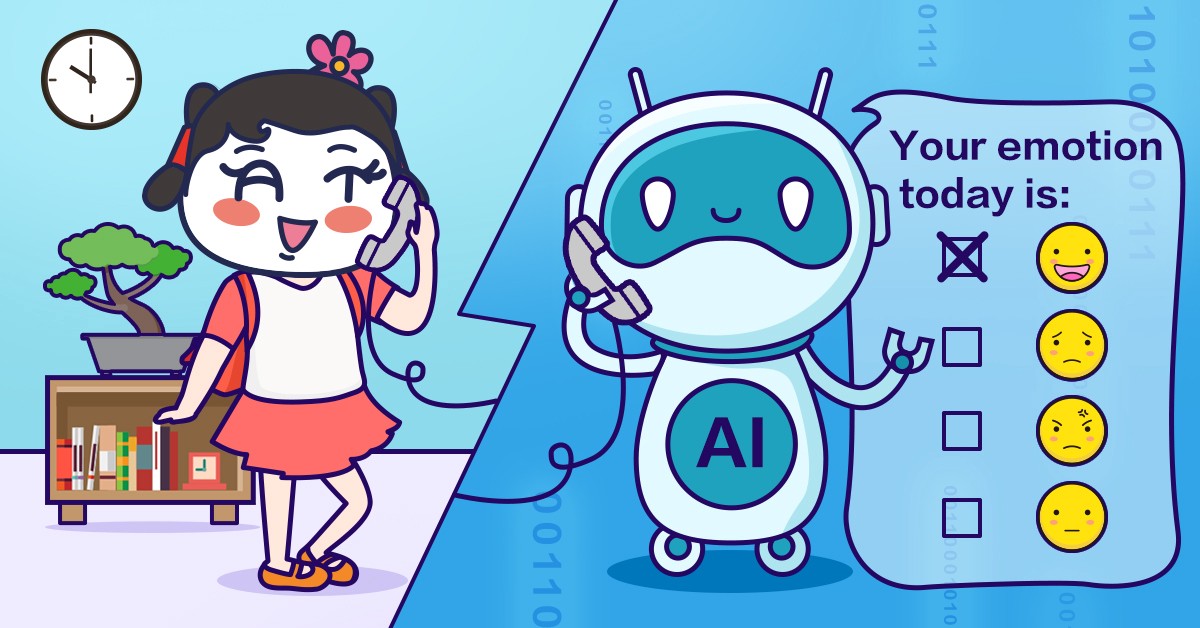
Ide dasar penelitian di bidang speech emotion recognition (pengenalan emosi dari sinyal wicara) adalah bahwa sinyal wicara mengandung informasi emosi dari pembicara. Contoh sederhana, suara orang marah akan sangat berbeda dengan suara orang sedih dan senang. Dengan mengenali (pola) suara orang marah, senang, sedih, dll, kita akan bisa mengenali emosi seseorang dari suaranya.  Berikut ilustrasi pengenalan emosi dari penelepon.
Pengenalan emosi penelepon secara otomatis oleh Artificial Intelligence (AI)
Sumber:https://medium.com/@alitech_2017/voice-based-emotion-recognition-framework-for-films-and-tv-programs-2a6abbb77242


Diagram Alir Sistem

Secara umum, sistem pengenalan emosi dari sinyal wicara terdiri dari dua blok utama (selain input dan output):
  1. Ekstraksi Fitur
  2. Klasifikasi
Kode yang kita buat pun juga disimpan dalam dua blok tersebut: save_feature.py dan ser_ravdess.py. Input system adalah speech dataset, dalam hal ini kita pakai dataset RAVDESS [3]. Output yang kita ingin kita capai adalah kategori emosi secara diskrit (01 = neutral, 02 = calm, 03 = happy, 04 = sad, 05 = angry, 06 = fearful, 07 = disgust, 08 = surprised).

Diagram blok pengenalan emosi dari sinyal wicara

Dataset

Sunday, April 21, 2019

Start-end silence removal dengan Librosa

Start-end silence removal

Start-end silence removal merupakan teknik untuk menghilangkan suara silence di awal dan akhir utterances (sinyal wicara). Teknik ini dilatarbelakangi bahwa kebanyakan silence berada pada awal dan akhir pembicaraan.

Dengan library librosa, menghilangkan silence pada awal dan akhir kalimat ini cukup mudah sebagai berikut,
import librosa
x, fs = librosa.load('Ses01F_impro01_F000.wav')  # ganti dengan nama file wav kamu
xt, ind = librosa.effects.trim(x, top_db=30)

Untuk melihat hasilnya, kita ceck panjang sinyal atau kita plot (bisa juga didengarkan suaranya dengan library sounddevice.

In [12]: len(x)
Out[12]: 42900

In [15]: len(xt)
Out[15]: 24576

Hasil plotnya adalah sebagai berikut:
figure()
subplot(211); plot(x)
subplot(212); plot(xt)


Perlu dicatat, karena saya menggunakan ipython --pylab, saya tidak perlu menuliskan plt.* untuk mengakses library matplotlib. Selain menghasilkan output `xt`, fungsi librosa.effects.trim yang digunakan untuk menghilangkan silence ini juga memberikan indeks (start, end) dimana sinyal xt diambil.

Perhatikan gambar di atas, yang ditandai dengan elips warna oranye adalah sinyal silence yang ingin kita hilangkan, sedangkan, didalam kotak merah adalah sinyal yang ingin kita ambil. Parameter utama untuk menghilangkan silence ini adalah threshold (dB).

Friday, March 15, 2019

Atensi, hubungannya dengan cocktail party problem dan deep learning

Beberapa hari ini saya kembali membaca beberapa paper tentang fenomena "cocktail party", tema penelitian saya saat S1 dan S2. Dulu, bahkan sampai minggu lalu, saya hanya membaca banyak paper dari aspek statitsik, algoritma, dan aplikasinya. Padahal teknik tersebut (ICA/BSS) diusulkan untuk meniru cara kerja otak manusia. Karena sedang mengambil kuliah tentang "perceptual", sekarang saya sedang membaca beberapa paper tentang bagaimana otak memproses fenomea "cocktail party". Kali ini, semua yang saya baca adalah tentang persepsi, kognisi dan proses biologi, bukan rekayasa matematika atau deep learning, tapi tentang jaringan saraf sebenarnya.

Atensi

Apakah atensi itu? Atensi merupakan proses kognitif dan perilaku untuk memilih informasi tertentu dan mengabaikan informasi lainnya. Studi tentang atensi ini mulai berkembang ketika Cherry pada tahun 1953 mempublikasikan papernya tentang eksperimen "shadowing task": dimana responden diperdengarkan dua pesan melalui headphone secara dichotic (satu pesan untuk tiap kanal, kanan dan kiri). Pesan terserbut merupakan pesan utama (attended) dan sampingan (non-attended). Cherry menemukan bahwa sangat kecil sekali reponden memperhatikan pesan sampingan, misalnya apakah pesan itu diucapkan oleh laki-laki/wanita, bahasa apa yang digunakan, dll. Eksperimen Cherry ini membuka jalan lahirnya teori tentang atensi dan beberapa modelnya.

Gambar 1. Model atensi Broadbent dan Treisman

Monday, February 04, 2019

Phase Unwrapping

Samakah hasil perhitungan: $ \cos (420^\circ)$ dengan $\cos (420^\circ-2\pi)$? Ide inilah yang (menurut saya) melatarbelakangi teknik phase unwrapping pada analisa sinyal.

Phase unwrapping adalah metode untuk "membuka" fase sinyal. Algoritma metode untuk unwrapping fase ini adalah sebagai berikut: "Jika selisih antara dua skalar fase dalam array lebih dari dikont, yakni $\pi$ (3.14, dalam radian), maka nilai skalar yang lebih tinggi tadi dikurangi $2 \pi$. Nilai diskont ini bisa dirubah, namun defaultnya adalah $\pi$.

Perhatikan contoh berikut. Vektor $x$ adalah array yang berisi fase dari suatu sinyal.

$$ px = [0~ 1~ 3.24~ 5~ 6.28~ 10~ 13~ 16]$$

Jika selisih antara $x[n]$ dengan $x[n+1]$ lebih besar dari $\pi$ maka dilakukan unwrapping fase. Sehingga untuk vektor fase $x$ diatas hasilnya adalah,

$$ px2 = [0.0~        1.0~        2.0~        3.24~      5.0~     
       6.28~      3.72~  6.72~ 9.72] $$

Vektor $px2$ merupakan hasil phase unwrapping dalam radian agar tracking fase terlihat lebih halus. Lihar gambar di bawah ini untuk hasil plot fase (atas) dengan unwrapping fase (bawah).

Plot fase (atas) dengan unwrapping fase (bawah)

Wednesday, January 16, 2019

Ketidaklinearan sistem pendengaran [6]

Catatan kuliah "Human perceptual model and its system", pertemuan ke-6.

Telinga manusia merupakan sistem yang tidak linear. Apa buktinya? Fakta berikut merupakan beberapa bukti ketidaklinearan sistem pendengaran manusia. Meskipun ada beberapa bukti kelinearan pada fenomena berikut (misalnya emisi spontan pada otoakustik), dengan menggunakan sifat ketidaklinearan fenomena tersebut justru menjadikannya masuk akal.

Respon basilar membrane (pemilihan frekuensi)

Pemilihan frekuensi: Kemampuan telinga untuk memisahkan komponen frekuensi dari suara kompleks. Basilar membrane hanya bergetar pada tempat/lokasi dimana frekuensinya sama (resonansi). Seperti diketahui sebelumnya, respon frekuensi pada basilar membrane berjalan dari frekuensi tinggi (base) menuju frekuensi rendah (apex). Response basilar membrane merupakan filter dimana fitter tersebut gabungan dari banyak bandpass filter. Karenanya filter auditori ini disebut filterbank.

Respone basilar membrane ini tidak liner. Dilihat dari skala yang digunakan (Bark dan ERB), keduanya menggunakan spasi logaritmik. Meski model auditory seperti gammatone masih menggunakan filter linear, namun model yang lain seperti double-resonance nonlinear (DRNL) menggunakan konsep nonlinear yang memberikan hasil yang lebih bagus daripada filter linear.

Contoh skala bark yang diturunkan dari konsep critical band (Zwicker model) seperti terlihat pada gambar di bawah. Perlu diingat bahwa skala yang lain, yakni ERB-rate, lebih banyak dipakai karena hasilnya cocok baik dari eksperimen psikoakustik maupun psikologi.
Auditori filter dalam frekuensi Bark

Wednesday, January 09, 2019

Fisiologi dari peripheral auditori dan pemodelannya [5]

Catatan kuliah human perceptual system and its model, pertemuan kelima, kelanjutan kuliah sebelumnya.

Sistem auditori merupakan sistem pemrosesan aktif, otak  turut andil dalam memproses gelombang mekanik suara menjadi sinyal nerve. Otak bisa menambah dan mengurangi gain dalam sistem auditori.

Mekanika kontrol otak ke sistem pendengaran tersebut juga meliputi  kemampuan otak untuk mengendalikan hair cell, artinya sistem efferent (dari otak ke peripheral) bisa mengontrol ketidak-linearan sistem pendengaran.

Lagi, bagian-bagian telinga dapat dipecah sebagai berikut:
Anatomi manusia (dimodifikasi dari Wikipedia)

Sunday, January 06, 2019

Analisa sinyal (suara) dan teknik sintesis [4]

Ini adalah catatan kuliah Human perceptual system and its model, pertemuan ke-4.

Suara yang dihasilkan microphone bukan murni suara kita, namun suara kita dikalikan dengan respon microphone (yang tidak flat).

Bagaimana menganalisa sinyal (suara)?
1. Pendekatan non-parameterik
2. Pendekatan parametrik

Analisa Non-parametrik

Untuk mendapatkan sinyal target digunakan metode tanpa mengasumsikan model tertentu.
Contoh:
$$Y(z) = H(z)X(z) + N(z)$$

Contoh dalam analisa suara:
- short term autocorrelation analysis
- short term spectral analysis
- cepstrum analysis
- band pass filter bank
- zero cross analysis

Tuesday, December 25, 2018

Representasi suara dan pemrosesannya [3]

Tulisan ini adalah kelanjutan tulisan sebelumnya, catatan kuliah "Human perceptual system and its model", pertemuan ketiga.

Motivasi:
Apa perbedaan pemrosesan linear dan pemrosesan non-linear?
Pemrosesan linear:Transformasi Fourier, Laplace, Z, Wavelet
Pemrosesan non-linear: Sistem auditori, sistem produksi suara, sistem audio
Lebih jauh tentang perbedaan sistem linear dan non-linear bisa dilihat disini: https://youtu.be/nxGmkAgJaA8

Bagaimana mempelajari pendengaran?
- Fisiologi auditori
- Psikofisika auditori (psikoakustik)

Monday, December 10, 2018

Pengantar Persepsi Manusia dan Pemodelannya [1]

Ini adalah catatan kuliah yang saya transkrip saat kuliah berlangsung untuk mata kuliah "Persepsi Manusia dan Pemodelannya", pertemuan pertama.

Persepsi: organisasi, identifikasi dan interpretasi informasi sensori untuk merepresentasikan dan memahami lingkungan.

Semua persepsi melibatkan sinyal dari sistem saraf (nerveous) yang dihasilkan dari stimulasi fisis dari organ pengindera.

Lima indera manusia:
- penglihatan
- pendengaran
- sentuhan
- perasa/pengecap
- penciuman

Kelima indera tersebut diindera oleh mata, telinga, kulit, lidah dan hidung.

1. Penglihatan
Mata merupakan indera penglihatan yang memiliki struktur kompleks terdiri atas lensa transparen yang memfokuskan cahaya pada retina. Retina sendiri terdiri atas dua organ penting, cell-rods dan cones. Cell-rods tidak sensitif terhadap warna namun sensitif terhadap cahaya daripada cones. Cones sensitif terhadap warna dan terletak pada bagian retina yang disebut fovea, dimana cahaya difokuskan oleh lensa. Manusia memiliki tiga cone (Red, green, blue) sedangkan anjing hanya memiliki dua saja (green dan blue), sehingga anjing tidak bisa membedakan warna hijau, kuning atau merah.

Penampang retina: rod, cones dan lapisan saraf (kiri-kanan)

Sunday, March 19, 2017

Bising Kereta Api: Sumber dan Solusinya

Kereta api merupakan moda transportasi utama. Di banyak negara (maju), kecanggihan dan kecepatan kereta api bahkan mampu mengalahkan pesawat. Sebagai contoh di Jepang dan beberapa negara Eropa, berkendara dengan kereta akan lebih cepat (dan tarifnya lebih mahal) dari pesawat. Hal ini dikarenakan trayek kereta yang berangkat dan menuju pusat kota, tidak seperti pesawat yang bandara-nya hampir dipastikan jauh di pinggir kota.

Fig 0. Kereta Bandara Soetta Produksi INKA [4]
Menilik rencana induk perkertaapian nasional yang di launching tahun 2011 (RIPNas), PT. KAI menarget kan kereta api sebagai leading transportaion line  yang dituangkan dalam RIPNas 2030. Rencana tersebut meliputi: Bab 1 Perkeretaapian Nasional, Bab 2 Strategi pengembangan jaringan layanan, Bab 3 Strategi peningkatan kemanan dan keselamatan, Bab 4 Strategi alih teknologi dan pengembangan industri, Bab 5 Strategi pengembangan SDM, Bab 6  Strategi pengembangan kelembagaan, Bab 7 Strategi Investasi dan Pendanaan serta Bab 8 Penutup. Sayang dalam RIPNas tersebut tidak membahas tentang dampak kebisingan yang diemisikan kereta api. Inilah yang akan saya bahas. Dalam RIPNas, hanya dibahas dampak polusi pada sub-bab ramah lingkungan. Sedangkan pada bidang keselamatan (safety) akan ditempuh kebijakan melalui: penyiapan regulasi, peningkatan keandalan dan koordinasi dengan pihak-pihak terkait. Tulisan ini juga mengusulkan langkah riil yang bisa ditempuh khusus untuk mitigasi kebisingan yang diakibatkan oleh kereta api.

Sunday, February 26, 2017

Ibnu Haytham: sang pendiri psikofisika?

Psychophysics, bisa diterjemahkan sebagai psikofisika, adalah ilmu yang mempelajari tentang hubungan stimulus dan sensasi. Contoh disiplin ilmu psikofisika ini adalah auditory scene analysis, metode yang diusulkan untuk memahami bagaimana sistem pendengaran manusia mampu fokus pada target suara padahal banyak sumber bising disekitarnya (bubble noise). Bruce (1996) menyatakan definisi psikofisika: the analysis of perceptual processes by studying the effect on a subject's experience or behaviour of systematically varying the properties of a stimulus along one or more physical dimensions. Khaleefa (1999) menjelaskan lebih detail perbedaan psikofisika dengan psikologi: The area into which psychologists study the link between variation in physical dimension and psychological dimension is called psychophysics, and the methodology used to describe this link is termed experimental psychology.

Cover "Element of Psychophysics", sumber: Internet Archieve

Ketika kita belajar suatu disiplin ilmu, ada baiknya siapakah peletak dasar ilmu tersebut. Bagaimana dengan psychophysics? Adalah Gustav Theodor Fechner, ilmuwan Jerman yang hidup pada 19 April 1801 hingga 18 November 1887. Dia disebut-sebut sebagai pendiri psikofisika dan psikologi eksperimental. Oya, psikofisika selalu digandengkan dengan psikologi eksperimental karena eksperimen untuk mendapatkan data psikofisika adalah eksperimen psikologi. Benarkah Gustav Fechner adalah pendiri psikofisika?

Wednesday, December 16, 2015

Forensik Suara di Indonesia: Past, Present and Future

Berikut adalah resume singkat saya saat mengikuti "Workshop Forensik Suara Ucap di Indonesia: Pas, Present and Future" yang diorganisir oleh Kelompok Keahlian Instrumentasi dan Kontrol, Teknik Fisika ITB. Workshop ini dibagi menjadi tiga sesi, sesi dari Komisi Pemberantasan Korupsi, sesi dari Puslabfor POLRI, dan sesi dari akademisi ITB.

Kebutuhan Penyidik akan Forensik Suara Ucap

Forensik suara ucap → Proses untuk menentukan apakah contoh dari suara seseorang (known sample) merupakan sumber dari suara yang diselidiki (unknown sample). Jenis alat bukti forensik suara ucap adalah sbb:
  • Rekaman suara 
  • Laporan forensik suara 
  • Pendapat ahli
Dari ketiga jenis alat bukti forensik suara diatas, jelas peran forensik sangat vital untuk bisa dijadikan referensi dalam menuntut tersangka/terdakwa dengan hukuman semaksimal mungkin. Didukung dengan barang bukti yang sah (real evidence), maka tugas KPK untuk menjerat koruptor akan semakin realistis. Dalam KUHAP Pasal 184 alat bukti yang sah adalah: keterangan saksi, keterangan ahli, surat, petunjuk dan keterangan terdakwa. Perluasan alat bukti (forms of evidence) ini mencakup alat bukti elektronik yang mencangkup rekaman suara maupun data pendukungnya. Trend penggunaan forensik suara dalam hukum semakin meningkat seiring berkembangnya teknologi. Dalam film-film spy Hollywood, penggunaan teknologi suara sudah di-imajinasikan sangat canggih sehingga kita bisa mengetahui posisi seseorang hanya dari suaranya saja, misal dalam film Bourne, Mission Impossible atau 007.

Sunday, November 22, 2015

Acoustic & Sound Engineer Training 2015

ASET (Acoustic and Sound Engineering Training) merupakan salah satu agenda diantara beberapa kegiatan ITB insight 2015. Materi ASET 2015 ini adalah sebagai berikut:
  1. Hearing Music
  2. Hearing Music in Different Environment
  3. Small Room Acoustics
  4. Music Production
Bagian keempat inilah sebenarnya esensi dari ASET 2015 ini. Pak Jack dari UPH Jakarta yang juga seorang praktisi sound engineer menjelaskan dengan gamblang tentang proses produksi music mulai dari gambaran proses produksi, pra produksi, produksi/recording dan paska produksi. Gambar 1 atas adalah screenshot software Reaper, sebuah DAW (digital audio work station) yang digunakan dalam ASET kali ini. Berikut adalah resume singkat tentang keempat tahapan produksi tersebut.

Screenshot Reaper 5.1, DAW yang digunakan pada ASET 2015

1. Gambaran proses produksi suara

Sunday, March 29, 2015

Noise Control: Low Vs High Frequencies

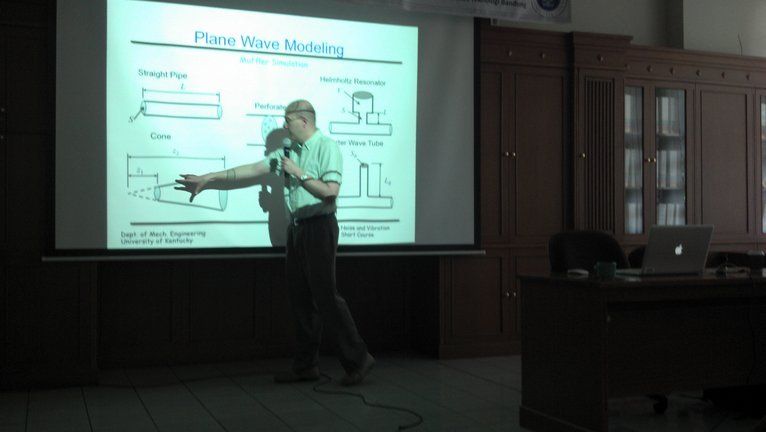
Pada awal tahun 2015 saya membukanya dengan mengikuti Workshop Akustik dan Vibrasi yang diadakan oleh Departemen Teknik Fisika ITB. Keynote speaker workshop kali ini adalah Prof. David Herrin dari univeristy of Kentucky, USA. Materi workshop pun cukup menarik dan sangat seusai dengan apa yang selama ini kami kerjakan di lab +VibrasticLab ITS Surabaya. Jadi kami sangat berharap workshop ini dapat meng-upgrade kemampuan kami di bidang Akustik dan Vibrasi, khususnya dalam hal noise control.

Pemaparan materi oleh Prof. David Herrin

Ada 15 materi (chapter) yang dibahas dalam workshop selama dua hari tersebut, mulai dari teori tentang "sound and vibration" sampai aplikasinya dalam desain akustik muffler (knalpot). Beliau, Prof, David Herrin adalah konsultan dari Harley Davidson. Ke-15 materi tersebut adalah sebagai berikut: Basic sound and noise, introduction to numerical acoustics, Application: Engine cover example, numerical simulation applied to compressor, acoustic FEM and AML, design for noise, applied noise control, design of partial enclosure, sound absorbing material, measurement of sound impedance and absorption, measurement of bulk properties, layered materials, design of muffler and silencer, muffler case studies, dan measurement of muffler insertion and transmission loss.

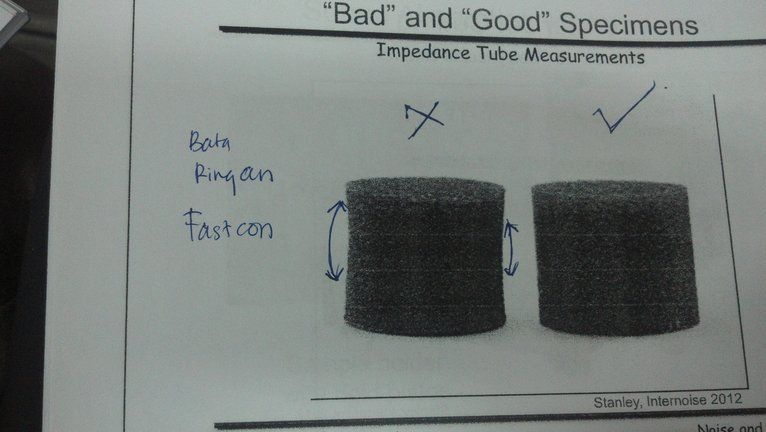
Salah satu isi dari workshop tersebut adalah efek dari pemotongan spesimen/bahan uji terhadap hasil pengukuran. Jika pemotongan spesimen tidak benar-benar presisi, maka terjadi loss terhadap pengukuran. Gambar berikut adalah dua spesimen yang berbeda pemotongan-nya (good and not-good/NG) sedangkan gambar dibawahnya adalah hasil pengukurannya. Garis warna merah menunjukkan hasil pengukuran pada pemotongan dengan diameter 1.375 inchi sedangkan garis warna kuning menunjukkan hasil pemotongan dengan diameter 1.360 inchi (berbeda 0.005 inchi).

Good and Bad specimen cutting
Hasil pengukuran dengan beda diameter 0.005 inchi

Tuesday, October 18, 2011

Generating White Noise Sound on Octave / Matlab


The following white noise sound was generated with GNU Octave's random number generator rand(), which generates uniformly distributed random values in the interval [0,1). The wavwrite() function expects values in [-1.0, 1.0), so we multiply by 2 and shift down by 1. So to generate 10 seconds of noise sampled at 48 kHz:
white=rand(48000*10,1)*2-1;
I'm not sure about the inner workings of /dev/urandom, but I used the "reseed" command to feed it data from random.org, so this should be pretty random. To export this to a 16-bit, 48 kHz .wav file in our home directory, the command is: