Monday, September 11, 2023

Changing Background of MOC Player to Transparent

The default background of MOC player (mocp) is ugly, see figure below. To change the default background of mocp, we can  do two steps below.

Step 1: Add theme to MOC configuration file in ~/.moc/config

XTermTheme = transparent-background
Step 2: Change file permission (to not allow other tha n user, group, to write)
$ chmod g-w ~/.moc/config/
That command will remove the permission of group (g) to write (-w).
List of available (default) themes:
  • black_theme
  • green_theme
  • red_theme
  • darkdot_theme
  • moca_theme
  • transparent-background
  • example_theme
  • nightly_theme
  • yellow_red_theme

The figures below show the change of theme from default to transparent-background.

Before

MOC Player default theme
After (with Terminal's Solarized theme)
MOC Player transparent theme

Friday, August 25, 2023

Mencoba TTS Bahasa Indonesia dengan VITs dan Meta MMS

Sudah lama saya ingin mencoba (membuat) teknologi text-to-speech (TTS) atau speech synthesis bahasa Indonesia. Percobaan pertama saya beberapa tahun lalu gagal. Disini reponya: Expressive-FastSpeech2. Pada percobaan tersebut, saya langsung mencoba membuat suara (bukan Bahasa Indonesia) yang memiliki emosi, seperti suara orang marah, sedih, atau senang. Alih-alih suara, saya hanya mendengar derau/bising saja dari algoritma FastSpeech2.

Ketika Meta/Facebook mengumumkan salah satu riset mereka, yakni MMS (Massively Multilingual Speech), saya langsung tertarik mencobanya. MMS bisa diaplikasikan untuk ASR (automatic speech recognition, atau STT, speech-to-text) dan TTS. Untuk TTS, sepemahaman saya, Meta hanya mengaplikasikan dataset yang besar pada Variational Inference with adversarial learning for end-to-end Text-to-Speech (VITS). Saya coba ASRnya tidak lebih baik dari OpenAI Whisper, khususnya dari sisi latency. Saya coba TTSnya, kebetulan hasilnya memuaskan, khususnya untuk yang belum pernah berhasil membuat TTS sendiri.

Repository

Untuk keperluan TTS ini, saya buat repository khusus di Github: TTS-Bahasa. TTS-Bahasa sebenarnya tidak khusus untuk bahasa Indonesia, tapi semua bahasa yang didukung oleh MMS (ada lebih dari 1000 bahasa). Repo tersebut saya adaptasi dari tutorial di laman MMS, yakni tutorial Google Colabnya. Saya hanya menambahkan satu skrip python CLI (command line interface) untuk memudahkan pembuatan audio file suara sintesis berdasarkan input kalimat. Contohnya seperti ini.

python3 mms_tts_ind.py --text "Selamat datang di Indonesia"
Suara berbahasa Indonesia akan diperdengarkan setelah eksekusi program selesai (berbunyi: "Selamat datang di Indonesia"). Luaran suara tersebut juga bisa disimpan dalam format WAV atau MP3, misalnya.
python3 mms_tts_ind.py --text "Selamat datang di Indonesia" -s -o selamat_datang.wav 
Untuk mencobanya, tidak perlu menginstall. Cukup clone repo tersebut, dan ikuti petunjuk di READMEnya. Jika ada kendala, anda bisa membuka "issues" di repo tersebut.

Demo

Jika anda bukan programmer, coder, researcher, mahasiswa teknik, atau tidak terbiasa dengan Python, anda bisa langsung mencoba demo-nya disini: https://bagustris.github.io/tts-bahasa/.

Tuesday, August 08, 2023

Menginstall ESPNET via Conda

Tulisan berikut merupakan catatan singkat instalasi ESPNET dengan Conda (OS: Ubuntu 20.04~).

Dari dokumentasi ESPNET, cara yang disarankan untuk menginsall ESPNET adalah melalui Conda.

./setup_anaconda.sh miniconda espnet 3.8
Namun dengan cara ini, environment conda menjadi tidak bernama sehingga kita perlu me-load conda dengan fullpath. Solusinya adalah dengan memberikan argumen yang tepat untuk `setup_anaconda.sh`, yakni $CONDA_ROOT. Pada Ubuntu, default CONDA_ROOT ada di `/home/$USER/miniconda3` (Setelah menginstall miniconda). Contohnya adalah sebagai berikut.
./setup_anaconda.sh /home/bagus/miniconda3/ espnet 3.9

Dengan cara ini kita bisa berpindah ke perintah instalasi selanjutnya, yakni `make`. Setelah terinstall, kita bisa mengaktifkan ESPNET dengan `conda activate espnet`. 


Catatan:

- Sebelum menginstall ESPNET, kita perlu menginstall cmake, python3-dev, sox, flac, dan build-essential via apt-get.

Saturday, August 05, 2023

Melanggan Medium

Minggu ini saya memutuskan untuk melanggan Medium. Biaya langganannya 5 USD/bulan. Medium, bagi yang belum tahu, adalah platform penerbitan daring yang menyediakan ruang bagi penulis dari berbagai bidang untuk berbagi pandangan, pengetahuan, cerita, dan pengalaman mereka. Saya tertarik dengan Medium karena menawarkan beragam konten menarik, dari esai inspiratif hingga artikel informatif yang membahas berbagai topik. 

Ada beberapa alasan kuat mengapa saya memutuskan untuk melanggan Medium untuk setahun kedepan: 

  • Beberapa konten dengan kualitas tinggi hanya bisa diakses dengan melanggan.  Medium menempatkan kualitas konten di atas hal lain; banyak penulisnya adalah penulis buku. Mereka menggali topik dengan mendalam dan menawarkan sudut pandang yang unik, membuat saya selalu terinspirasi dan berpikir lebih jauh. 
  • Bisa dibayar dari program partner. Agar mendapatkan bayaran dari artikel yang kita tulis, kita harus menjadi pelanggan melalui Medium Partner Program.
  • Beragam Topik yang Menarik: Medium menawarkan berbagai macam topik yang bisa dipilih sesuai minat dan hobi saya. Entah itu teknologi, pengembangan diri, psikologi, budaya, atau bisnis, saya selalu menemukan konten yang relevan dan bermanfaat bagi pengetahuan saya. 
  • Komunitas dan Interaksi: Medium juga memiliki komunitas yang aktif dan ramah. Saya senang membaca komentar dan tanggapan dari pembaca lain yang menambah wawasan saya tentang suatu topik. Selain itu, Medium memiliki fitur "clap" yang memungkinkan saya untuk memberikan apresiasi atas tulisan yang saya nikmati. 
  • Memotivasi untuk menulis lebih. Saya pernah menulis untuk menulis satu artikel per minggu (https://bagustris.blogspot.com/2020/03/new-article-every-weekend.html). Namun, hal ini sangat sulit ternyata! Dengan medium, saya berharap target ini bisa tercapai (logika: karena berbayar saya harus menulis, tidak saja membacanya).

Saya akan lihat (evaluasi) setahun mendatang apakah Medium ini memberikan benefit yang lebih dari 5 USD/per bulan. Harapan saya untuk setahun mendatang adalah: 

  1. Lebih Banyak Artikel saya yang Menarik: Saya berharap untuk menemukan lebih banyak artikel yang mendalam dan berbobot di Medium. Semakin banyak penulis berbakat yang bergabung dan berkontribusi, semakin kaya pula konten yang akan tersedia bagi para pembaca. 
  2. Pengembangan Diri sebagai Penulis (baik dari sisi kuantitas dan kualitas): Dengan membaca dan belajar dari penulis-penulis hebat di Medium, saya berharap untuk terus mengembangkan kemampuan menulis saya sendiri. Saya ingin mengasah kemampuan untuk menyajikan informasi dengan cara yang menarik dan dapat dipahami oleh pembaca. 
  3. Berbagi Kontribusi yang berdampak: Saya bermimpi suatu hari nanti bisa berkontribusi dengan menulis artikel berdampak tinggi di Medium. Bagaimana mengukur dampaknya? Medium menyediakan statistik siapa yang hanya melihat artikel kita dan siapa yang benar-benar membaca artikel kita. Metrik kedua ini yang saya kejar.
  4. Menjalin Lebih Banyak Koneksi: Medium adalah tempat yang tepat untuk menjalin hubungan dan koneksi dengan penulis dan pembaca dari seluruh dunia. Saya berharap bisa berinteraksi lebih banyak dengan mereka, berdiskusi, dan berbagi inspirasi. 

Demikianlah cerita mengapa saya memilih untuk melanggan Medium.com dan harapan saya untuk tahun mendatang.Selanjutnya, tulisan-tulisan dalam bahasa Indonesia akan saya tulis di Blogger ini sedangkan artikel bahasa Inggris akan saya tulis di akun Medium saya.

Evaluasi 2024:  

Setelah satu tahun melanggan Medium, saya putuskan berhenti. Selama setahun saya hanya mempublikasikan enam artikel atau rata-rata hanya satu artikel per dua bulan. Dengan membayarpun  (dan kemungkinan dapat bayaran juga), belum bisa memotivasi saya untuk lebih masif menulis di Medium. Ada banyak alasan; mungkin saya lebih terbiasa dan nyaman di Blogger ini daripada di sana.

Tuesday, July 25, 2023

Live microphone visualization (waveform) with sounddevice

 *** This post was made by ChatGPT***


Are you interested in visualizing live audio data from your microphone? Do you want to see the waveform of your voice or any other sound in real time? In this blog post, we’ll explore a Python script that utilizes Matplotlib to plot live microphone signals. This script is a useful tool for understanding and analyzing audio input in real time.

Before we begin, make sure you have sounddevice, Matplotlib, and NumPy installed. If not, you can install them using the following command:

pip install matplotlib numpy sounddevice

Now, let’s dive into the code and see how it works.

The Code

#!/usr/bin/env python3
"""Plot the live microphone signal(s) with matplotlib.

Matplotlib and NumPy have to be installed.

"""
import argparse
import queue
import sys

from matplotlib.animation import FuncAnimation
import matplotlib.pyplot as plt
import numpy as np
import sounddevice as sd

The script starts with the usual shebang (#!/usr/bin/env python3) and a brief docstring explaining the purpose of the code. It also imports the necessary modules: argparse, queue, sys, FuncAnimation from matplotlib.animation, plt (alias for matplotlib.pyplot), numpy, and sounddevice.

Next, the code defines two helper functions and two main functions.

def int_or_str(text):
    """Helper function for argument parsing."""
    try:
        return int(text)
    except ValueError:
        return text


def audio_callback(indata, frames, time, status):
    """This is called (from a separate thread) for each audio block."""
    if status:
        print(status, file=sys.stderr)
    # Fancy indexing with mapping creates a (necessary!) copy:
    q.put(indata[::args.downsample, mapping])

The int_or_str function is a helper used for parsing command-line arguments. It tries to convert the input text to an integer and returns it if successful; otherwise, it returns the input text as it is.

The audio_callback function is called for each audio block received from the microphone. It receives indata (the audio data), frames (the number of frames), time (the timestamp of the audio data), and status (the status of the audio stream). It prints any status messages to the standard error and puts a copy of the audio data (filtered using downsampling and channel mapping) into a queue (q) for processing later.

def update_plot(frame):
    """This is called by matplotlib for each plot update.

    Typically, audio callbacks happen more frequently than plot updates,
    therefore the queue tends to contain multiple blocks of audio data.

    """
    global plotdata
    while True:
        try:
            data = q.get_nowait()
        except queue.Empty:
            break
        shift = len(data)
        plotdata = np.roll(plotdata, -shift, axis=0)
        plotdata[-shift:, :] = data
    for column, line in enumerate(lines):
        line.set_ydata(plotdata[:, column])
    return lines

The update_plot function is called by Matplotlib for each plot update. It retrieves audio data from the queue (q) and shifts the existing data to accommodate the new audio block. The function then updates the y-data of the lines on the plot with the new audio data.

if __name__ == "__main__":
    # ... (continued in the next code block)

The script uses the standard Python if __name__ == "__main__": guard to ensure that the following code is only executed when the script is run directly, not when it’s imported as a module.

    parser = argparse.ArgumentParser(add_help=False)
    parser.add_argument(
        '-l', '--list-devices', action='store_true',
        help='show list of audio devices and exit')
    args, remaining = parser.parse_known_args()
    if args.list_devices:
        print(sd.query_devices())
        parser.exit(0)

The code sets up an argument parser with argparse to handle command-line arguments. It allows the user to list available audio devices and exit the program without running the main functionality. If the user specifies the --list-devices flag, the script will print a list of audio devices using sd.query_devices() and then exit.

    parser = argparse.ArgumentParser(
        description=__doc__,
        formatter_class=argparse.RawDescriptionHelpFormatter,
        parents=[parser])
    parser.add_argument(
        'channels', type=int, default=[1], nargs='*', metavar='CHANNEL',
        help='input channels to plot (default: the first)')
    parser.add_argument(
        '-d', '--device', type=int_or_str,
        help='input device (numeric ID or substring)')
    parser.add_argument(
        '-w', '--window', type=float, default=200, metavar='DURATION',
        help='visible time slot (default: %(default)s ms)')
    parser.add_argument(
        '-i', '--interval', type=float, default=30,
        help='minimum time between plot updates (default: %(default)s ms)')
    parser.add_argument(
        '-b', '--blocksize', type=int, help='block size (in samples)')
    parser.add_argument(
        '-sr', '--samplerate', type=float, default=16000, help='sampling rate of audio device')
    parser.add_argument(
        '-n', '--downsample', type=int, default=1, metavar='N',
        help='No downsample (default: %(default)s)')
    args = parser.parse_args(remaining)

The script creates another argument parser, this time with a description based on the script’s docstring. It defines several command-line arguments:

  • channels: The channels to plot. If not specified, it will default to the first channel.
  • device: The input audio device to use. It can be specified either by a numeric ID or a substring of the device name.
  • window: The visible time slot in milliseconds. This controls how much of the audio history is displayed on the plot.
  • interval: The minimum time between plot updates in milliseconds.
  • blocksize: The block size (number of samples) for audio processing. If not specified, the default block size of the audio stream will be used.
  • samplerate: The sampling rate of the audio device. If not specified, it will default to 16000 Hz.
  • downsample: The factor by which the audio data is downsampled. By default, no downsampling is applied.

The parse_args method is called to parse the remaining command-line arguments (remaining) after handling the --list-devices option.

    if any(c < 1 for c in args.channels):
        parser.error('argument CHANNEL: must be >= 1')
    mapping = [c - 1 for c in args.channels]  # Channel numbers start with 1
    q = queue.Queue()

The code checks if any of the specified channels are less than 1. If so, it raises an error with an appropriate message. It then creates a mapping list for the channel indices, as the channel numbers in args.channels start from 1.

Full code is listed below. Actually, it is based on an example from sounddevice documentation [1].
#!/usr/bin/env python3
"""Plot the live microphone signal(s) with matplotlib.

Matplotlib and NumPy have to be installed.

"""
import argparse
import queue
import sys

from matplotlib.animation import FuncAnimation
import matplotlib.pyplot as plt
import numpy as np
import sounddevice as sd


def int_or_str(text):
    """Helper function for argument parsing."""
    try:
        return int(text)
    except ValueError:
        return text


def audio_callback(indata, frames, time, status):
    """This is called (from a separate thread) for each audio block."""
    if status:
        print(status, file=sys.stderr)
    # Fancy indexing with mapping creates a (necessary!) copy:
    q.put(indata[::args.downsample, mapping])


def update_plot(frame):
    """This is called by matplotlib for each plot update.

    Typically, audio callbacks happen more frequently than plot updates,
    therefore the queue tends to contain multiple blocks of audio data.

    """
    global plotdata
    while True:
        try:
            data = q.get_nowait()
        except queue.Empty:
            break
        shift = len(data)
        plotdata = np.roll(plotdata, -shift, axis=0)
        plotdata[-shift:, :] = data
    for column, line in enumerate(lines):
        line.set_ydata(plotdata[:, column])
    return lines


if __name__ == "__main__":

    parser = argparse.ArgumentParser(add_help=False)
    parser.add_argument(
        '-l', '--list-devices', action='store_true',
        help='show list of audio devices and exit')
    args, remaining = parser.parse_known_args()
    if args.list_devices:
        print(sd.query_devices())
        parser.exit(0)
    parser = argparse.ArgumentParser(
        description=__doc__,
        formatter_class=argparse.RawDescriptionHelpFormatter,
        parents=[parser])
    parser.add_argument(
        'channels', type=int, default=[1], nargs='*', metavar='CHANNEL',
        help='input channels to plot (default: the first)')
    parser.add_argument(
        '-d', '--device', type=int_or_str,
        help='input device (numeric ID or substring)')
    parser.add_argument(
        '-w', '--window', type=float, default=200, metavar='DURATION',
        help='visible time slot (default: %(default)s ms)')
    parser.add_argument(
        '-i', '--interval', type=float, default=30,
        help='minimum time between plot updates (default: %(default)s ms)')
    parser.add_argument(
        '-b', '--blocksize', type=int, help='block size (in samples)')
    parser.add_argument(
        '-sr', '--samplerate', type=float, default=16000, help='sampling rate of audio device')
    parser.add_argument(
        '-n', '--downsample', type=int, default=1, metavar='N',
        help='No downsample (default: %(default)s)')
    args = parser.parse_args(remaining)
    if any(c < 1 for c in args.channels):
        parser.error('argument CHANNEL: must be >= 1')
    mapping = [c - 1 for c in args.channels]  # Channel numbers start with 1
    q = queue.Queue()

    try:
        if args.samplerate is None:
            device_info = sd.query_devices(args.device, 'input')
            args.samplerate = device_info['default_samplerate']

        length = int(args.window * args.samplerate / (1000 * args.downsample))
        plotdata = np.zeros((length, len(args.channels)))

        fig, ax = plt.subplots()
        lines = ax.plot(plotdata)
        if len(args.channels) > 1:
            ax.legend([f'channel {c}' for c in args.channels],
                      loc='lower left', ncol=len(args.channels))
        ax.axis((0, len(plotdata), -1, 1))
        ax.set_yticks([0])
        ax.yaxis.grid(True)
        ax.tick_params(bottom=False, top=False, labelbottom=False,
                       right=False, left=False, labelleft=False)
        ax.text(0.01, 0.99, f'Sample rate: {args.samplerate/args.downsample} Hz', transform=ax.transAxes, va='top', ha='left')

        fig.tight_layout(pad=0)

        stream = sd.InputStream(
            device=args.device, channels=max(args.channels),
            samplerate=args.samplerate, callback=audio_callback)
        ani = FuncAnimation(fig, update_plot, interval=args.interval, blit=True)
        with stream:
            plt.show()
            
    except Exception as e:
        parser.exit(type(e).__name__ + ': ' + str(e))
Save it as sd_plot_input.py (or whatever name.py) and run it with the following commands. See the video above for the sample output.
$ python3 sd_plot_input.py


Reference: 

  1. https://python-sounddevice.readthedocs.io/en/0.4.6/examples.html#plot-microphone-signal-s-in-real-time

Thursday, July 20, 2023

Memilih default Kernel Linux di Ubuntu (22.04)

Setelah upgrade ke kernel 5.19, terjadi masalah "screen flickering" pada Laptop (kantor) saya, Dell XPS 9320. Padahal laptop ini adalah certified hardware, Link: https://ubuntu.com/certified/202112-29761. Hanya saja Canonical sudah berdalih, karena saya membelinya dengan pre-installed Windows (11), bukan Ubuntu.

...Standard images of Ubuntu may not work well, or at all. (https://ubuntu.com/certified/202112-29761)

Karena menyebabkan sakit mata jika screen flickering ini dibiarkan, saya mencari solusinya. Biasanya ini adalah permasalahan yang disebabkan karena update kernel, dan benar saja AskUbuntu memberikan jawaban yang serupa:


https://askubuntu.com/questions/1455799/ubuntu-22-04-2-screen-flickering-glitches.


Untuk mengecek kernel di Ubuntu, saya menggunakan perintah berikut.
$ uname -a
Linux bagus-XPS-9320 linux-image-5.19.0-46-generic #6-Ubuntu SMP PREEMPT_DYNAMIC Tue Jan 24 18:24:09 UTC 2023 x86_64 x86_64 x86_64 GNU/Linux
Permasalahannya ada di kernel 5.19 yang saya gunakan tersebut.
 
Untuk melihat list kernel yang tersedia bisa dengan cara berikut (bisa juga lewat Advanced options saat booting).
$ sudo apt list --installed | grep linux-image
linux-image-5.15.0-60-generic/now 5.15.0-60.66 amd64 [installed,local]
linux-image-5.19.0-46-generic/jammy-updates,jammy-security,now 5.19.0-46.47~22.04.1 amd64 [installed,automatic]
linux-image-6.0.0-1012-oem/now 6.0.0-1012.12 amd64 [installed,local]
linux-image-6.1.0-1006-oem/now 6.1.0-1006.6 amd64 [installed,local]
linux-image-generic-hwe-22.04/jammy-updates,jammy-security,now 5.19.0.46.47~22.04.21 amd64 [installed,automatic]
bagus@xps-9320:~$ 

Solusinya adalah mengganti kernel. Cara pertama untuk mengetes solusi ini adalah reboot dan masuk ke Advanced options dan memilih kernel lain (dalam hal ini 6.1) dan cek apakah screen flickering masih terjadi.

Cara kedua adalah dengan mengganti kernel 5.19 menjadi 6.1 by-default secara otomatis. Ini adalah yang saya gunakan, tapi carannya beda dengan cara yang diterangkan oleh AskUbuntu di atas (tapi didapat dari AskUbuntu lainnya [2]). Pertama back-up file grub.
sudo cp /etc/default/grub /etc/default/grub.bak
Kedua edit `LINUX_DEFAULT=0` menjadi kernel yang dituju. Dalam hal ini saya menggunakan menu "Advanced options for Ubuntu" dan kernelnya, digabung dengan tanda ">". Berikut isi grub saya. Perhatikan dua baris teratas, baris pertama adalah konfigurasi lama (dikomen) dan baris kedua adalah konfigurasi baru.
$ sudo vim /etc/default/grub
#GRUB_DEFAULT=0
GRUB_DEFAULT="Advanced options for Ubuntu>Ubuntu, with Linux 6.1.0-1006-oem"
GRUB_TIMEOUT_STYLE=hidden
GRUB_TIMEOUT=10
GRUB_DISTRIBUTOR=`lsb_release -i -s 2> /dev/null || echo Debian`
GRUB_CMDLINE_LINUX_DEFAULT=""
GRUB_CMDLINE_LINUX=""
#GRUB_CMDLINE_LINUX_DEFAULT="i915.enable_dc=0 intel_idle.max_cstate=2"
Terakhir adalah update-grub
$ sudo update-grub

Dan reboot laptop. Setelah sekian lama mengetik tulisan ini, screen flickering tidak terjadi. 


Referensi:

  1. https://askubuntu.com/questions/1455799/ubuntu-22-04-2-screen-flickering-glitches
  2. https://askubuntu.com/questions/216398/set-older-kernel-as-default-grub-entry

Wednesday, May 31, 2023

Kenapa tidak ada kursi bernomor I di pesawat?


Sudah lama saya bertanya-tanya, ketika naik pesawat, kenapa tidak ada nomor tempat duduk "I" di pesawat. Dan hari ini, ketika sesorang menanyakan hal itu (lebih tepatnya komplain), saya langsung googling. Jawaban Google, berdasarkan Wikipedia, adalah sebagai berikut:

On many aircraft, the rightmost seats have letter designations HJK, skipping the letter I. This is because each seat has a row number followed by letter; letters that may be confused with numbers (I, O, Q, S, or Z) must be avoided, usually for people with dyslexia.

Jadi jawabannya, kenapa tidak ada huruf I, juga tidak ada huruf O, Q, S, dan Z, di pesawat adalah untuk menghindari keambiguan.

I ambigu dengan angka 1,

O dan Q ambigu dengan angka 0,

S ambigu dengan angka 5, dan

Z ambigu dengan angka 2.

Orang dengan disleksia, kondisi di mana seseorang mengalami kesulitan belajar yang menyebabkan masalah pada proses menulis, mengeja, berbicara, dan membaca, akan sulit membedakan huruf-huruf di atas sehingga akan kesulitan menemukan tempat duduknya di pesawat.

Monday, April 10, 2023

DON'T DO USELESS THINGS!


Apa contoh hal-hal yang tidak berguna:

  • Memaksa anggaran untuk hal yang tidak perlu. Saya pernah mendapatkan anggaran yang harus dipakai. Karena tidak ada kebutuhan khusus, saya ngasal aja memakai anggaran tsb untuk membeli PC dengan spek rendah. Walhasil PC tersebut tidak terpakai (meski foldable, touch screen, dll).
  • Membuat peraturan yang terlalu keras dan tidak ada relevansinya. Contohnya, kalau tidak menjalankan XXX maka akan mendapatkan YYY. Cek lagi, apakah YYY berkorelasi (positif) dengan XXX? Apakah YYY, misalnya sanksi, itu produktif?
  • Media sosial, termasuk YouTube, IG, dll. Kadang kita membuka youtube dengan tujuan untuk belajar, untuk berbagi. Cek lagi, apakah dari 100% waktu kita bermedsos atau menonton youtube, IG, Facebook 90% tercapai? Jika tidak, berhenti dari memakai aplikasi tsb, meski bermanfaat.
  • Ketika kita sudah belajar untuk tidak menggunakan waktu kita untuk hal sia-sia, maka jangan biarkan orang lain (baligh mukallaf) untuk melakukan hal yang serupa sia-sia.
  • Cari hiburan? Apakah Nabi cari hiburan? Kebanyakan hiburan adalah hal yang sia-sia, hanya sedikit yang tidak termasuk di dalamnya. Memanah, berkuda, dan berenang adalah hiburan, tapi bukan sia-sia.
  • Cara mudah untuk mendeteksi apakah hal tersebut sia-sia adalah: apakah ada manfaatnya ketika kita melakukan hal tersebut?
  • Ingat kembali misi (hidup, organisasi), cek apakah yang yang dilakukan sudah selaras dengan misi tsb.
     

Friday, March 31, 2023

Research Plan 2023

Seperti biasa, bulan April adalah tahun barunya jepang (Fiscal year、年度). Satu tahun (akademik, fiskal, kerja, dll. kecuali pajak) dihitung per 1 April dan berakhir 31 Maret. Jadi kalau bisa, pas hidup di Jepang, lahir tanggal 1 April, meninggal tanggal 31 Maret. Kenapa begitu? Kalau lahir 20 April, anda tidak bisa mengikuti sekolah (SD, SMP, SMA) tahun itu juga kalau belum umurnya. Misalnya umur minimal SD adalah 6 tahun per 1 April. Kalau lahir 20 April berarti nunggu tahun depannya. Begitu juga beasiswa, kerja, dll, hampir semua dimulai per 1 April.

Singkat saja, berikut adalah rencana penelitian saya satu tahun mendatang. Tahun ini saya akan fokus mengembangkan sistem multilingual speech emotion recognition (SER) dengan riset tambahan tentang anomaly detection (vibration and sound) dan melanjutkan riset sebelumnya tentang text-independent speech emotion recognition. Semoga semua luaran tahun ini bisa tercapai, alih-alih bisa melebihi luaran yang diharapkan.


Tuesday, March 14, 2023

Kopi dan Produktifitas

 Dalam sebuat Twitter feed, seorang user berkicau?

Adakah tool untuk meningkatkan produktivitas selain dengan minum kopi?

Ada banyak jawaban dari kicauan itu. Ada yang menjawab dengan minuman lain kesukaannya, jus buah. Ada yang menyarankan musik klasik. Ada juga yang menyarankan musik khusus yang dibuat untuk menemani kerja (khususnya programming, https://musicforprogramming.net/latest/).  Saya baca-baca jawabannya lainnya, tidak ada yang masuk (untuk saya).

Saya pernah mencoba bekerja sambil mendengarkan musik (seperti musik programming di atas), dan kadang berhasil. Sebagai seorang muslim, saya juga mencoba bekerja sambil mendengarkan tilawah, dan kadang berhasil. Namun, sampai sekarang, saya belum menemukan tool lain yang bisa meningkatkan produktivitas (yakni: fokus, membuat kerja jadi selesai, efektif, dan efisien) seampuh kopi.

Khusus untuk tilawah, permasalahan utama ada pada keistiqomahan. Untuk minum kopi, saya otomatis menyambar gelas di disamping saya tapi tidak otomatis memutar tilawah padahal saya membutuhkannya. Qori favorit saya: Ali Jaber, Salaah Ba'uthman,  dan Abdulallah Al-Mathrood. Suara tilawah menurut saya lebih mirip musik klasik (dari sisi ke efek gelombang otak) daripada music for programming di atas. Tilawah dipercaya meningkatkan laju pertumbuhan tanaman. Senada dengan musik klasik dan tilawah, suara juga dapat dimodifikasi untuk menstimuli gelombang yang bisa mentrigger gelombak otak tertentu via brainwave synchronization. Ketiganya belum dapat menggantikan kedudukan kopi untuk meningkatkan produktivitas. Kalau mau dibuat variasi, Kopi dan Tilawah adalah perpaduan paling sempurna seperti yang dikampanyekan Nuh Saunders. 

Kembali ke pertanyaan yang mirip dengan pertanyaan user Twitter di atas: adakah tool yang bisa meningkatkan produktivitas seampuh kopi? Tidak ada. Kalau efektivitasnya di bawah kopi, mungkin ada. Tapi buat apa...? Kalau ada tool yang lebih efektif, pastinya pilih yang lebih efektif, kecuali bosan.

Sediakan kopi untuk meningkatkan kinerja anda dan teman-teman anda.

Friday, March 10, 2023

Antara Tukang Cuci Piring dan Editor Jurnal

Alkisah. Seorang teman bercerita, dia mendapat dua pilihan pekerjaan sampingan. Pertama sebagai pencuci  piring. Kedua sebagai editor jurnal. Kerena bimbang untuk memilih salah satu diantara dua pekerjaan tersebut, beliau meminta pertimbangan istrinya. Berikut diskusi mereka.

Istrinya bertanya, 

"Berapa waktu yang dibutuhkan untuk mereview satu jurnal?" 

Sang suami menjawab, 

"Kira-kira empat jam". 

Istri melanjutkan, 

"Berapa bayaran review dan mengedit satu jurnal itu?"

Suami menjawab,

"Seratus dua puluh lima ribu rupiah". 

Istri bertanya lagi, 

"Berapa bayaran cuci piring?"

Suami menjawab:

"1000 yen jam per jam".

Akhirnya si istri mengakhiri diskusi dengan solusinya.

"Ya udah, kamu ambil kerjaan cuci piring saja, kamu sedekahkan separo dari bayaran cuci piringmu ke masjid di Indonesia, itu jauh lebih bermanfaat dari menjadi bekerja paruh waktu sebagai editor jurnal."

Wednesday, March 08, 2023

Dari Narita, Cikarang, Jakarta, Solo, dan Madiun

Sebuah cerita dari perjalanan selama lima hari saat pulang ke Indonesia (Januari 2013).

Berangkat dari Kameyama-shi, selasa pagi pukul 04.30 JST, saya di jemput oleh Kokubu-san, kemudian kami ke rumah sachou (Pak Direktur) untuk menjemput sachou dan dilanjutkan ke Tsu Port, Ibukota propinsi Mie di Jepang. Kapal yang membawa kami dari Tsu Seaport ke Central Japan Airport, Chubu, berangkat tepat pukul 6.00. Selama kurang lebih sejam berada di kapal cepat, akhirnya kami mencapai Chubu airport.

Di Chubu air port, tiga moda transportasi disatukan: udara, laut dan darat. Begitu praktis dan efisiennya kehidupan di Jepang. Semuanya di desain untuk memudahkan hidup, bukan mempersusahnya. Inilah realiasi pajak yang saya bayar tiap bulannya di Negeri ini. Pemerintah (Jepang) pun melaksanakan tugasnya (memudahkan hidup rakyat) dengan cukup baik.

Dari Chubu, kami berangkat naik pesawat ke Narita sekitar pukul 8.30, dengan waktu perjalanan sekitar 40 menit. Sebelum jam 10 kami sudah mendarat di Narita, Tokyo. Dari terminal domestik Narita, kami oper (Jepang: norikae) dengan shuttle bis bandara menuju terminal 1, terminal international yang akan membawa kami ke Indonesia.

Jika pergi dari Jepang ke Indonesia, pilihan terbaik memang menggunakan Garuda, tanpa bermaksud promosi. Pengurusan visa (untuk warga negara asing seperti Jepang) bisa dilakukan setelah check in, sehingga kita tidak perlu mengurus visa on arrival ketika datang di Indonesia. Pesawat Garuda membawa kami meninggalkan Tokyo pukul 12.50 waktu setempat, dan kami tiba di Jakarta pukul 18.30 waktu setempat. Perjalanan ditempuh selama 6 jam termasuk perbedaan waktu antara Narita - Tokyo.

Satu hal agar kita tidak rugi selama naik pesawat adalah dengan memaksimalkan fasilitas yang ditawarkan pesawat. Tiga film saya tonton dalam rentang beda waktu 6 jam. Namun fasilitas lain sepertinya Garuda kalah dengan maskapai lain, seperti Korean Air. Dengan harga tiket yang tidak jauh beda, Korean Air menawarkan fasilitas lebih (per tahun 2013).

Pertama tujuan kami adalah Cikarang (setelah mendarat di Sukarno-Hatta AP), di sana kami tinggal selama tiga hari sebelum bertolak ke Madiun via Solo (Adi Sumarno AP). Dari Solo ke Madiun, dari Madiun ke Solo lagi untuk menemui LPK (lembaga pelatihan kerja), milik orang yang memperkenalkan diri sebagai seorang yang berdarah biru, di dekat stadion Manahan. Kemudian, kami balik ke Jakarta untuk ke Narita. Perjalanan lima hari yang melelahkan untuk mengobati kerinduan kepada orang tua dan negeri tercinta.

Tuesday, February 21, 2023

Multi-device PCs with single keyboard and mouse

In today's digital age, it's common for people to use multiple devices for their work or personal use. Whether it's for multitasking or switching between devices, using multiple keyboards and mice can be a frustrating and inefficient experience. Fortunately, there's a solution to this problem: using a single keyboard and mouse for multiple PCs. This setup not only saves desk space but also improves productivity and reduces clutter. In this blog post, we'll explore the importance of using a single keyboard and mouse for multiple PCs, the benefits it offers, and how to set up this configuration for optimal performance. So, let's dive in and learn why using a single keyboard and mouse is a game-changer for those who use multiple devices! 

Dell KM7321
Dell KM7321 multi-devices keyboard and mouse, as advertised on Dell's web. This keyboard and mouse can connect up to three PCs; one PC with a Bluetooth dongle and two PCs with embedded Bluetooth or additional Bluetooth dongles.


PC setup 

Here is my setup using three PCs (two desktops and one laptop).


Keyboard + Mouse: Dell KM7321W (KM7321WYG) 
Technology: Bluetooth (universal pairing receiver)

I mainly used two PCs as follows (with a laptop as an optional third device). It also works for three PCs; however, since the third is a laptop on a different table, it will make my work more complicated than using two PCs. 

PC1: Iiyama (Dell Bluetooth dongle) 
I set the universal pairing dongle in this PC Iiyama. The OS is Ubuntu 20.04. Other hardware may not directly impact the performance, but I used the following; 95 GB RAM, RTX3090 (full four monitors), with i7-10900 CPU. Should work on other hardware too,

PC2: HP Omen (Embedded Bluetooth) 

The second PC is the HP Omen 30 L (2021). GPU is RTX 3090, 64GB RAM, and Ubuntu 20.04 as the OS. I intended to use this PC as a computing unit, while the first one, PC Iiyama, for all tasks (paper writing, computation, etc.). For bigger computation, I used another PC with double RTX 3090. Result There is no software configuration needed. The only problem (previously) is to connect the keyboard to the second PC. For connecting the mouse, both PC 1 and PC 2 can connect smoothly. To connect the keyboard, we need to input six characters shown when pairing to the PC (shown in the PC). Since it was a keyboard, I didn't understand how to input these digits (like a smartphone or tablet). I tried it on Windows, and it shows a similar requirement (asking to enter six digits for the keyboard). I tried to push the number shown on the PC via the keyboard button (without knowing the pressed digits were correct) and then pressed enter. Whoala, the keyboard is now connected to the second PC. I tried similar things on Ubuntu, and it works. Finally, the image below is now my working workstation (two desktops, both the first and second PC are not shown since it is hidden under my table, only the monitors are shown).


A single keyboard to rule all three PCs.

PC3: IIyama 17" (Optional, just to test, embedded/buil-in bluetooth)
The third PC is a laptop with Windows 10. So, besides multi-device, this setup can also work in multi-OS. Since it is a hardware-based, different approach from software-based like Synergy, it is expected to work on any OS as long as the hardware supports Bluetooth.

Note, as advertised, the mouse and keyboard support Swift pairing (without inputting the digits with a close distance between both devices). But, as I reported, this feature fails on my PCs. It may be too far. Being able to connect both devices (keyboard and second/third PC) via a physical button is enough to make the device work as intended.

Update after a week of use

Adjusting the monitor position is important. I used three monitors for the main PC (PC IIyama) and one monitor for the second PC (HP Omen, mainly for coding).

Since I have an additional mouse (the old one), I just need to change the keyboard only for two devices. It is smoother than changing both the keyboard and mouse.

It is also more convenient to use a single keyboard and mouse than using "ssh" for remote work. The use of GUI-based remote control like TeamViewer has been banned in my office. So, this solution is worth trying.

Does it work with an external Bluetooth dongle?
I haven't tried it yet (still ordering a Buffalo Bluetooth dongle). I will report here once a test has been performed.  Yes. It does work with external Bluetooth. See the manual page for details.

Reference: 
 [1] https://www.dell.com/support/home/en-us/product-support/product/dell-premier-multi-device-wir-kybrd-mse-km7321w/docs

Tuesday, January 10, 2023

Dual Afiliasi

Salah satu cita-cita saya yang belum tercapai adalah dual afiliasi, bekerja di dua institusi dan memberi manfaat untuk keduanya dengan mengisi kekurangan satu insitusi dengan kelebihan institusi lainnya, begitu pula sebaliknya. Contoh terbaik untuk kasus ini adalah Bjorn Schuller (Imperial College dan Audeering), Yan Lecun (Facebook dan New York University), Junichi Tsujii (AIST dan Manchester University), dan Junichi Yamagishi (NII dan Edinburg University).

Contoh dari manfaat dual afiliasi adalah pada riset dan publikasi akademik. Biaya publikasi akan tertutupi oleh institusi yang secara finansial lebih stabil. Keuntungan untuk institusi yang secara finansial lebih stabil adalah pada kolaborasi. Contohnya pada institusi privat (Swasta), dimana butuh usaha ekstra untuk merekrut peneliti dan kolaborator. Sebaliknya, hal tersebut mudah dilakukan di universitas. Institusi privat tidak perlu mengeluarkan waktu dan biaya ekstra untuk proyek mereka.

Manfaat utama dual afiliasi ada pada siklus teori dan praktek. Dosen (seperti Lecun) yang bekerja di sektor swasta secara dual afiliasi akan dengan mudah menangkap permasalahan nyata (praktek) di lapangan/industri, alih-alih permasalahan teoritik di buku teks. Mahasiswa dari dosen yang bersangkutan juga akan memecahkan permasalahan nyata, the real problem, bukan sebatas permasalahan yang ada di buku teks. Permasalahan (soal-soal) di buku teks tetap penting untuk mengasah teori atau konsep dasar dan kerangka berpikir dalam menyelesaikan permasalahan nyata.

Double Universitas

Selain dual afiliasi universitas dan industri, dual afiliasi bisa juga dilakukan pada dua (atau lebih) kampus yang berbeda. Banyak dosen China yang mengambil dual afiliasi dengan universitas Jepang untuk memanfaatkan kebaikan dan kelebihan universitas Jepang (~2020). Dosen-dosen China tersebut tinggal di Jepang dan hanya pulang ke China ketika dibutuhkan saja. Dengan cara yang sama, banyak dosen-dosen Eropa bertebaran tidak di negaranya (sesama Uni Eropa) dengan memanfaatkan kelebihan-kelebihan kampus papan atas Uni Eropa untuk mendongkrak reputasi universitas Uni Eropa lainnya.

Keterbatasan Untuk Dosen PNS

Ada keterbatasan PNS (atau dosen yang berstatus sebagai PNS). Keterbatasan rangkap jabatann tersebut seperi yang didiskusikan di sini: 

https://www.hukumonline.com/klinik/a/hukumnya-rangkap-menjadi-asn-sekaligus-pegawai-swasta-lt5ed13c19b8117. 

Diperlukan usaha ekstra untuk mewujudkan dual afiliasi sebagai dosen PNS dan praktisi di tempat lain (atau peneliti di institusi lain). Hukum perlu diubah agar lebih fleksibel demi kemajuan ilmu pengetahuan dan teknologi di negara kita.


p.s.:Dual afilias yang saya maksud adalah yang bersifat long-term di dua institusi, akademik dan universitas luar negeri atau industri/institusi riset. Bukan tugas belajar, izin belajar dan sejenisnya.

Wednesday, January 04, 2023

Tools for Academic Writing in 2023

When writing a scientific paper, I use several tools below to boost and speed up my writing process. Hence, I only need two weeks to a month to complete the first version of my manuscript (after the experiment has been conducted). Two tools are paid: Copilot and Grammarly. Before going down to the list below, you may also be interested in my resources for academic writing - word concordance [1]. For last year's tool (2022), specializing on both research and paper writing instead of paper writing only, you can check it here [2].

  1. Mendeley (the old desktop version, not the new reference manager, to create a BIB file automatically)
  2. Grammarly (vscode plugin)
  3. Latex Workshop (vscode plugin)
  4. Copilot (vscode plugin)
  5. ChatGPT (to ask questions)
By using these tools, I DON'T need to:
  • Create bibliography manually
  • Sometimes, write all sentences in paragraphs since Copilot will do it.
  • Check the grammar manually.
  • Create Table, Figure, and Equation manually in Latex (thanks to Latex Workshop).
Other tools (unexplored well, in progress for adaptation)
  1. https://www.explainpaper.com (tool to explain any hard-to-understand terms/sentences in a paper)
  2. https://elicit.org/ (like ChatGPT, but with reference)
  3. LTeX – LanguageTool grammar/spell checking (alternative to Grammarly, free)

Reference
[1] http://bagustris.blogspot.com/2020/07/resources-for-academic-writing-word.html
[2] https://bagustris.blogspot.com/2023/01/tools-i-used-for-accelerating-science.html

Tuesday, December 27, 2022

Mengikuti Sekolah Mengemudi Di Jepang

Tulisan ini adalah catatan pengalaman saya mengikuti sekolah mengemudi di Jepang di awal tahun 2022.

Kenapa driving school?

Ada tiga jalur untuk mendapatkan SIM di Jepang, yakni:

1. Jalur Sekolah (自動車学校, jidousha gakko)

2. Jalur Konversi (外免切替, gaimen kirikae)

3. Jalur Umum (普通一種一般試験, futsu isshu ippan shiken)

Dari ketiga jalur di atas, kenapa saya memilih jalur driving school?

1. Saya belum pernah 'pegang' mobil secara formal dan tidak punya SIM A untuk dikonversi.

2. Meski saya bisa saja belajar sendiri kemudian lewat jalur formal, namun waktunya akan sangat lama (1-2 tahun) kalau pakai jalur umum. Waktu tempuh ini juga berlaku untuk mereka yang sudah bisa (bahkan pandai menyetir).

3. Jalur driving school adalah yang paling cepat meski paling mahal.

Oya, ada dua tipe driving school di Jepang: driving school yang punya lisensi untuk tes tulis 50 soal dan praktek, dan driving shool yang tidak punya lisensi tersebut. Saya memilih driving school tipe pertama.

Pendaftaran

Satu-satunya kelemahan jalur driving school adalah biaya pendaftaran yang mahal, yakni sekitar 336,000 yen. Namun, seperti telah saya sampaikan di atas, jalur ini adalah yang tercepat. Saya hanya butuh sekitar dua bulan dari hari pertama les nyetir sampai dengan mendapatkan SIM resmi (bukan SIM belajar atau kari menkyou). 

Untuk info kursus mengemudi yang saya ikuti adalah sebagai berikut.

Nama : Tsuchiura Driving School (Tsuchiura Jidouka Gakkou)

Web: https://tsuchikyo.menkira.jp/

Alamat: 

〒300-0843 茨城県土浦市中村南 4-1-20

TEL 029-841-0577

Tips saat mendaftar: Jika anda bisa bahasa Jepang sehari-hari, jangan bilang kalau tidak bisa bahasa Jepang. Cukup bilang 日本語は大丈夫です。

Gambar 1. Mobil yang digunakan untuk latihan (Toyota)


Alur  

Ada empat tahapan atau langkah untuk mendapatkan SIM untuk semua jalur di atas.

1. Tes Praktek I untuk Kari Menkyou

2. Tes Tulis 50 soal

3. Tes Praktek II

4. Tes Tulis 100 soal

Jika keempat langkah di atas lulus, maka SIM bisa didapatkan. Jika langkah 1-2 terpenuhi, maka SIM belajar (kari menkyou) bisa didapatkan. Jika ada satu saja langkah di atas yang gagal, maka SIM tidak bisa didapatkan. Untuk mengulang setiap langkah ada biaya tambahan, untuk semua jalur. Kasus saya gagal sekali pada tes 50 soal dan mengulang dan membayar biaya test tsb (1700 yen untuk sekali tes).

Kelas

Hari Pertama

Hari pertama ini bisa dibilang fullday. Jam pertama dimulai  jam 9:50 dan berakhir jam 17:50. Istirahat dua kali, jam 11:15-11:50 dan jam 12:50-13:30. Ada tiga kelas (学会, gakkai)sekaligus, yakni kelas 1, 6, dan 9. Oya, total ada 26 kelas yang dibagi menjadi dua periode (sebelum dan setelah kari menkyou/SIM belajar). Total praktek sekitar 12 kali (12 jam). Di kelas pertama tadi dikenalkan pengertian kendaran (車, kuruma) yang meliputi mobil (自動車), sepeda (自転車), dan sepeda motor (モトバイク). Poin-poin penting kelas 1 meliputi: seat belt, child seat, driving license, dan surat kelayakan kendaraan (車検). Poin-poin penting kelas 6 membahas banyak tentang perempatan (tata cara belok, berhenti, lurus). Kelas 9 lebih banyak membahas tentang pejalan kali, zebra cross, mengemudi di samping pejalan kali, sepeda, kursi roda dan sejenisnya.  Pada hari pertama ini ada dua (jam) praktek. Praktek pertama dengan simulator meliputi: persiapan sebelum mengemudi (cek depan dan belakang), menyetel kursi, menstarter mobil, memindahkan handle dari P, ke R, N, D, S, B (sambil menginjak rem), belok kanan dan belok kiri (tangan dalam keadaan lurus untuk putaran setir > 180 derajat). Praktek kedua adalah dengan mobil asli setelah melalui simulator.

Hari Kedua

Pada hari kedua ada dua kelas dan dua praktek. Kelas pertama adalah kelas 8 membahas tentang perempatan meliputi cara berpindah jalur, menyalip, dan belok kiri kanan. Praktek pertama di hari kedua ini (praktek ketiga secara total) adalah latihan belok (putaran) kanan, kebalikan dari hari pertama. Belok kanan dan kiri berbeda, putaran belok kanan lebih sedikit dari belok kiri. Kelas kedua yakni kelas 10 membahas tentang jenis-jenis SIM (ada tiga: kelas 1, kelas 2, SIM belajar), jenis-jenis SIM dari berat kendaraan dan pelanggaran lalu lintas beserta hukumannya. Setiap melanggar, selain tindakan langsung (tilang) berupa uang, pelanggar akan dikenakan poin. Jika poin tersebut sudah mencapai batas, SIM akan dicabut baik sementara atau permanen. Pada praktek kedua saya berlatih belok kanan dan kiri (sasetsu dan usasetsu). Praktek ini juga meliputi implementasi kelas 8 yakni cara berpindah jalur: lihat room mirror, side mirror, nyalakan sein, hitung tiga detik, tengok kanan, pindah jalur. Praktek kedua ini sangat penting untuk membiasakan menyetir.

Hari ketiga

Hari ketiga mirip dengan hari sebelumnya: dua kelas dan dua praktek. Kelas pertama dimulai dari buku "Rules of the Road" hal 114 berkaitan dengan menyalip, kapan dilarang menyalip, di mana dilarang menyalip dan sejenisnya. Contohnya larangan menyalip adalah ketika mobil di depan kita juga mau menyalip. Contoh tempat dilarang menyalip adalah tanjakan. Kelas kedua berkaitan dengan mobil-mobil emergensi: ambulans, pemadam kebakaran, dan polisi (untuk mengutamakan mobil tersebut). Praktek pertama naik tanjakan dan pindah lajur kanan (berhenti sejenak, rem tangan, gas pelan, lepas rem tangan, bel, reteng kanan, D-->S, turun sambil injak rem pelan-pelan, berhenti, S --> D. Praktek kedua di tikungan S dan J. Poin penting praktek kedua ini adalah injakan rem dan kapan memutar dan mengembalikan handle dengan melihat jalan.

Hari keempat

Skema hari keempat sama dengan hari sebelumnya, dua teori (kelas) dan dua praktek. Kelas pertama berkaitan lampu lalu lintas (merah, kuning, hijau dengan empasis kuning harus berhenti pada dasarnya, kecuali sudah melewati garis putih). Lamu lalu lintas di Jepang berbeda dengan Indonesia, meski hijau tidak serta merta jalan, menunggu mobil dari arah lawan, jika kosong baru bisa jalan. Kelas kedua berkaitan dengan rambu-rambu lalu lintas (secara garis besar dibagi dua, rambu di pinggir jalan dan rambu di permukaan jalan). Praktek pertama dan kedua sama, course seperti gambar di bawah. Bedanya, praktek pertama mbak instrukturnya gaul (pernah tinggal di Jakarta tujuh tahun), sedangkan praktek kedua mbak instrukturnya judes.

Hari kelima

Seingat saya hari kelima hanya teori saja.

Hari keenam

Hari keenam hanya dua praktek. Dua-duanya sama, praktek kedua mengulang praktek pertama. Praktek ini adalah gladi resik untuk praktek I. Rutenya seperti gambar di bawah.
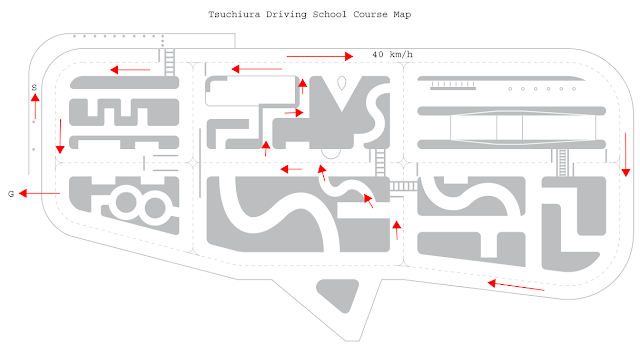
Gambar 2. Rute Latihan / Tes Praktek I


Tes Tulis 50 Soal (Hari ketujuh)

Hari ketujuh adalah test untuk step 1. Tes ini merupakan test praktek dengan course C sesuai gambar. Untuk mengambil tes ini harus lulus pre-test online 1, 2, dan 3. Masing-masing test online untuk step 1 berisi 50 soal benar atau salah. Untuk lulus harus memiliki skor (benar) minimal 45. Ada trik khusus untuk test online ini. Setelah test akan muncul review atas jawaban benar dan salah. Highlight semua pertanyaan dan jawaban kemudian print di browser dalam bentuk pdf. Ketika mengulang lagi, tinggal melihat jawaban yang benar. Meski pertanyaannya acak, ada banyak pertanyaan yang sama untuk tiap pre-test tersebut sehingga file pdf sebelumnya sangat membantu untuk mencari jawaban yang benar. Dari test praktek saya mendapat masukan untuk menginjak rem lebih halus dan tidak mendadak. Setelah test praktek adalah test tulis. Meski saya sudah lulus tiga pre-test online di test tulis ini saya tidak lulus. Saya gagal di tes pertama 50 soal untuk mendapatkan kari menkyou. Walhasil saya harus mengulang dan membayar pendaftaran 1700 yen. Jadwal short-term plan saya juga langsung berubah menjadi basic plan.


Hari ke delapan dan seterusnya lupa tidak tercatat, tapi catatan berikut di bawah ini cukup bermanfaat.


Tes Praktek I

Tes praktek I ini secara umum mudah karena hanya di lintasan di dalam driving school (tidak keluar ke jalan raya). Beberapa hal yang perlu diperhatikan adalah saat sebelum mengemudi (cek spion tengah, side mirror) kemudian toleh kanan kiri dan start. Minimal kecepatan pada jalan lurus adalah 40 km/jam sekali saja. Kecepatan pada saat belok maksimal 15 km/jam. Belokan S juga diujikan pada tes praktek I ini.

Mikiwame

Mikiwame adalah semacam gladi resik untuk tes praktek (II). Jadi materinya hampir sama dengan test praktek II. Pada mikiwame ini saya mengendarai mobil di rute yang akan dijadikan test, termasuk juga mengendarai mobil di arena di dalam driving school. Beberapa teknik yang di-teskan antara lain houkohenkan (putar balik) dan parkir. Pada hari tes, dua dari teknik tersebut akan dipilih salah satu secara acak.

Tes Praktek II

Meski berhasil pada tes praktek II ini, ada banyak pelajaran yang bisa di ambil. Utamanya adalah untuk "mendahulukan yang mudah daripada yang sulit" (無理しないでください). Kasus pertama pelajaran tersebut ketika berada di perempatan untuk belok kanan. Di Jepang, belok kanan tidak bisa langsung meski lampunya hijau, jadi mobil harus maju pelan-pelan sampai di tengah perempatan menunggu mobil dari arah kiri kosong (atau panah kanan hijau menyala pada lampu lalu lintas). Karena mobil di depan saya maju, saya juga ikut maju di belakangnya. Di akhir test, instruktur mengatakan bahwa saya terlalu mempersulit diri. Baiknya, menunggu di belakang zebra cross, tidak perlu mengikuti mobil di depan ke tengah perempatan. Kasus kedua ketika putar balik (Gambar 2, bagian kiri atas), saya beberapa kali maju dan mundur untuk mengatur agar mobil pas di tengah (seperti parkir). Di akhir instruktur mengatakan, karena bukan parkir, kamu gak perlu bersusah payah mengatur mobil, intinya mobil bisa putar balik (mundur, belok kiri, dan belok kanan). Alhamdulillah meski agak susah saya lulus di tes praktek II ini.

Tes Tulis 100 soal di Mito: 

LULUS!

Ini adalah tes terakhir, bukan di driving school tapi di menkyou senta (Mito-shi). Alhamdulillah saya langsung lulus di tes pertama ini. Tipsnya banyak-banyak buku "Master of your driving in Japan" saja. Penantian kelulusan ini mirip-mirip ujian, menunggu nomor kita ada di layar monitor (lulus) atau tidak. Alhamdulillah nomor saya muncul di layar, langsung dapat SIM hari itu juga (setelah tes mata dan mengikuti arahan-arahan lainnya). Qodarullah, sehari setelah dapat SIM saya langsung dapat mobil. Alhamdulillah.
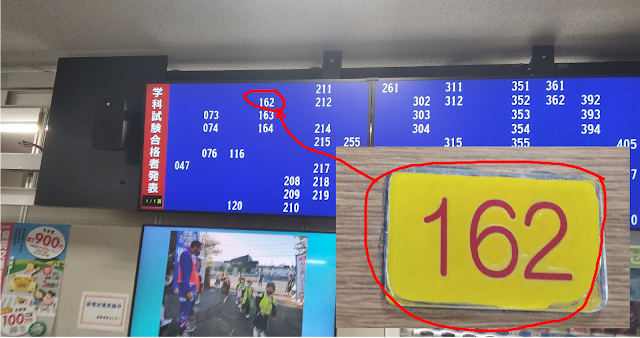
Gambar 3. Nomor ujian saya, 162, muncul di layar menandakan kelulusan ujian SIM di Jepang


P.S: Jika anda ingin mengikuti driving school di Tsuchiura Driving School, anda bisa memasukkan nama saya dan alamat saya  untuk mendapatkan potongan biaya 7000 yen (referral). Silahkan email saya di (btatmaja[at]gmail[dot]com) untuk mendapatkan alamat saya.

Friday, November 25, 2022

Konversi Fail Stereo ke Mono Dari Direktori Berisi Banyak Fail Suara

Skrip berikut dapat merubah fail suara stereo ke mono dari suatu direktori (termasuk subdirektori di dalamnya) yang diberikan.
Input: Direktori/folder
Output: Fail berakhiran "_mono" dengan direktori yang sama terhadap input (termasuk subdirektori)
#!/usr/bin/env python3
import os
import argparse
import glob
from pydub import AudioSegment

def stereo2mono(files):
    """Convert all files from stereo to mono.
    Note: this would effectively also create a copy of files that were already in a mono format
    Parameters
    ----------
    files : iterable
        Sequence of files
    Example use:
    ```
    $ python3 stereo2mono.py -f /path/to/audio/files/
    ```
    Then you may remove the files that do not contain the '_mono' tag with: 
    $ find . -name "*-??.wav" -delete # for emovo
    """
    for f in files:
        print(f"Converting {f}")
        # Load audio
        sound = AudioSegment.from_wav(f)
        # Convert to mono
        sound = sound.set_channels(1)
        # Save file
        stem, ext = os.path.splitext(f)
        sound.export(f'{stem}_mono{ext}', format='wav')


if __name__ == '__main__':
    parser = argparse.ArgumentParser(description='Convert stereo to mono')
    parser.add_argument('-f', '--folder', 
        type=str, help='Path to wavfiles')
    args = parser.parse_args()
    files = glob.glob(args.folder + '**/*.wav', recursive=True)
    stereo2mono(files)
Contoh penggunaan
# Konversi ke mono
python3 stereo2mono.py -f tensorflow_datasets/downloads/extracted/ZIP.emovo.zip/EMOVO/
# menghapus file yang bukan mono
$ pwd
/home/bagus/tensorflow_datasets/downloads/extracted/ZIP.emovo.zip/EMOVO/
$ find . -name "*-??.wav" -delete
Referensi gist:
1. https://gist.github.com/bagustris/40b406d99820207bc804a020db169f7e

Friday, September 09, 2022

Installing TexLive 2022 on Ubuntu 22.04 under Multipass

Multipass is a game changer. It looks like a virtual environment for python or a virtual box for OS, but for Ubuntu instances only (the hosts can be Windows and MacOS). This short writing documented my effort to enable the installation of TexLive 2022 for adding IEEE header and footer for camera-ready APSIPA 2022.

Host environment

bagus@L140MU:~$ snap --version
snap    2.56.2
snapd   2.56.2
series  16
ubuntu  20.04
kernel  5.15.0-46-generic
bagus@L140MU:~$ multipass --version
multipass   1.10.1
multipassd  1.10.1

Steps

1. Install multipass (refer to this link for detail).
2. Create an instance with Jammy (Ubuntu 22.04)
multipass launch jammy --disk 10G 
Launched: famed-chaffinch

2. Login to Jammy's shell (change the name of instance)
 multipass shell famed-chaffinch
3. Update Jammy
 sudo apt update
4. Install texlive and required packages
sudo apt install texlive-base texlive-fonts-extra texlive-fonts-recommended texlive-publisher
5. Try on the desired latex template
$ wget https://www.apsipa2022.org/APSIPA_ASC_2022_Template.zip
$ sudo apt install unzip
$ unzip APSIPA_ASC_2022_Template.zip
$ cd APSIPA_ASC_2022_Template/Latex
$ pdflatex PaperSample_Guideline_tex.tex
...
Output written on PaperSample_Guideline_tex.pdf (3 pages, 126525 bytes).
Transcript written on PaperSample_Guideline_tex.log.
That's all. For 20.04, it will throw to an infinite recursion loop due to the lower fancy version. The only solution is to install newer Latex on Ubuntu 22.04 under multipass. For real cases, you may need to mount your local directory (which contains TEX files) to an instance with `multipass mount`.
$ multipass mount $HOME famed-chaffinch

Tuesday, August 23, 2022

Acoustic Feature Extraction with Transformers

The example in Transformers' documentation here shows how to use the wav2vec 2.0 model for automatic speech recognition. However, there are two crucial issues in that example. First, we usually use our data (set) instead of their (available) dataset. Second, we need to extract acoustic features (the last hidden states instead of logits). The following is my example of adapting Transformers to extract acoustic embedding given any audio file (WAVE) using several models. It includes the pooling average from frame-based processing to utterance-based processing for given any audio file. You don't need to perform the pooling average if you want to process your audio file in frame-based processing (remove the `.mean(axis=0)` in the variable `last_hidden_states`).

Basic syntax: wav2vec2 base model

This is the example from the documentation. I replaced the use of the dataset with the defined path of the audio file ('00001.wav').

from transformers import Wav2Vec2Processor, Wav2Vec2Model
import torchaudio
import torch
# load model
processor = Wav2Vec2Processor.from_pretrained("facebook/wav2vec2-base-960h")
model = Wav2Vec2Model.from_pretrained("facebook/wav2vec2-base-960h")

# audio file is decoded on the fly
array, fs = torchaudio.load("/data/A-VB/audio/wav/00001.wav")
input = processor(array.squeeze(), sampling_rate=fs, return_tensors="pt")

# apply the model to the input array from wav
with torch.no_grad():
    outputs = model(**input)

# extract last hidden state, compute average, convert to numpy
last_hidden_states = outputs.last_hidden_state.squeeze().mean(axis=0).numpy()

# print shape
print(f"Hidden state shape: {last_hidden_states.shape}")
# Hidden state shape: (768,)


The syntax for the wav2vec2 large and robust model

In this second example, I replace the base model with the large and robust model without finetuning. This example is adapted from here. Note that I replaced 'Wav2Vec2ForCTC' with 'wav2vec2Model'. The former is used when we want to obtain the logits (for speech-to-text transcription) instead of obtaining the hidden states.

from transformers import Wav2Vec2Processor, Wav2Vec2Model
import torch
import torchaudio

# load model
processor = Wav2Vec2Processor.from_pretrained(
    "facebook/wav2vec2-large-robust-ft-swbd-300h")
model = Wav2Vec2Model.from_pretrained(
    "facebook/wav2vec2-large-robust-ft-swbd-300h")

# audio file is decoded on the fly
array, fs = torchaudio.load("/data/A-VB/audio/wav/00001.wav")
input = processor(array.squeeze(), sampling_rate=fs, return_tensors="pt")

with torch.no_grad():
    outputs = model(**input)

last_hidden_states = outputs.last_hidden_state.squeeze().mean(axis=0).numpy()
# printh shape
print(f"Hidden state shape: {last_hidden_states.shape}")
You can replace "facebook/wav2vec2-large-robust-ft-swbd-300h" with "facebook/wav2vec2-large-robust-ft-libri-960h" for the larger fine-tuned model.

 For other models, you may need to change `Wav2Vec2Processor` with `Wav2Vec2FeatureExtractor` for processor variable. In my case, this is needed for the following models:
  • facebook/wav2vec2-large-robust
  • facebook/wav2vec2-large-xlsr-53

The syntax for the custom model (wav2vec-R-emo-vad)

The last one is the example of the custom model. The model is wav2vec 2.0 fine-tuned on the MSP-Podcast dataset for speech emotion recognition. This last example differs from the previous one since the configuration is given by the authors of the model (read the code thoroughly to inspect the details). I replaced the dummy audio file with the real audio file. It is assumed to process in batch (with batch_size=2) by replicating the same audio file.

import torch
import torch.nn as nn
from transformers import Wav2Vec2Processor
from transformers.models.wav2vec2.modeling_wav2vec2 import (
    Wav2Vec2Model,
    Wav2Vec2PreTrainedModel,
)
import torchaudio


class RegressionHead(nn.Module):
    r"""Classification head."""

    def __init__(self, config):

        super().__init__()

        self.dense = nn.Linear(config.hidden_size, config.hidden_size)
        self.dropout = nn.Dropout(config.final_dropout)
        self.out_proj = nn.Linear(config.hidden_size, config.num_labels)

    def forward(self, features, **kwargs):

        x = features
        x = self.dropout(x)
        x = self.dense(x)
        x = torch.tanh(x)
        x = self.dropout(x)
        x = self.out_proj(x)

        return x


class EmotionModel(Wav2Vec2PreTrainedModel):
    r"""Speech emotion classifier."""

    def __init__(self, config):

        super().__init__(config)

        self.config = config
        self.wav2vec2 = Wav2Vec2Model(config)
        self.classifier = RegressionHead(config)
        self.init_weights()

    def forward(
            self,
            input_values,
    ):

        outputs = self.wav2vec2(input_values)
        hidden_states = outputs[0]
        hidden_states = torch.mean(hidden_states, dim=1)
        logits = self.classifier(hidden_states)

        return hidden_states, logits


def process_func(
    wavs,
    sampling_rate: int
    # embeddings: bool = False,
):
    r"""Predict emotions or extract embeddings from raw audio signal."""

    # run through processor to normalize signal
    # always returns a batch, so we just get the first entry
    # then we put it on the device
    # wavs = pad_sequence(wavs, batch_first=True)
    # load model from hub
    device = 'cpu'
    model_name = 'audeering/wav2vec2-large-robust-12-ft-emotion-msp-dim'
    processor = Wav2Vec2Processor.from_pretrained(model_name)
    model = EmotionModel.from_pretrained(model_name)

    y = processor([wav.cpu().numpy() for wav in wavs],          
                   sampling_rate=sampling_rate,
                   return_tensors="pt",
                   padding="longest"
        )
    y = y['input_values']
    y = y.to(device)


    y = model(y)

    return {
        'hidden_states': y[0],
        'logits': y[1],
    }


## test to an audiofile
sampling_rate = 16000
signal = [torchaudio.load('train_001.wav')[0].squeeze().to('cpu') for _ in range(2)]

# extract hidden states
with torch.no_grad():
    hs = process_func(signal, sampling_rate)['hidden_states']
print(f"Hidden states shape={hs.shape}")

Please note for all models, the audio file must be sampled with 16000 Hz, otherwise, you must resample it before extracting acoustic embedding using the methods above. It may not throw an error even if the sampling rate is not 16000 Hz but the results, hence, is not valid since all models were generated based on 16 kHz of sampling rate speech datasets. 

You may also want to extract acoustic features using the opensmile toolkit. The tutorial for Windows users using WSL is available here: http://bagustris.blogspot.com/2021/08/extracting-emobase-feature-using-python.html.

Happy reading. Don't wait for more time to apply these methods to your own audio file.

Wednesday, August 17, 2022

Siapa yang seharusnya membersihkan sampah B?

Andaikan sebuah eksperimen pikiran sebagai berikut.

A mengadakan suatu acara (panitia acara). B mengikuti acara tersebut (peserta acara). Jika B membuang sampah secara sembarangan di saat mengikuti acara tersebut, siapa yang wajib membersihkannya?

Jika anda masih menjawab A. Kita tambahkan kasus lain seperti ini.

B berada di rumahnya sendiri. B membuang sampah secara sembarangan di rumahnya sendiri. Siapa yang seharusnya membersihkan sampah B?

B yang seharusnya membuang sampahnya sendiri, tak peduli dimanapun. Selama itu sampahnya, maka dia sendiri yang wajib membuangnya, bukan orang lain.